

两阶段关键词管线:AI将胸部X光片自动转化为放射报告初稿
#AI照护与医疗科技 时间2026-10-16 05:31:47
文/IAICA.NGO®
放射科医生正被影像淹没。每一张进入阅片工作站的胸部X光片,最终都必须被翻译成一份结构化、临床精确的报告,而这项翻译工作至今仍主要由人工完成。随着影像检查量的增长速度持续超过放射科人力的增长速度,如何在保证质量的前提下提升报告产出效率,成为全球医疗机构共同面对的难题。
发表于 BMC Medical Imaging 的一项研究给出了新的技术蓝图。来自卡塔尔多哈哈马德医疗公司的 Souha Aouadi 及其同事,与哈马德·本·哈利法大学的合作者共同提出了一套人工智能工作流,通过精心设计的两阶段管线,将成对的胸部X光片自动转换为放射报告初稿。该研究在追求模型性能的同时,也回应了医疗人工智能领域一个更为稀缺的诉求:可解释性。
问题本身描述起来很简单,解决起来却极为困难。撰写放射报告要求医生先在图像中识别细微征象,再将其归入具有临床意义的类别,最后用流畅、标准化的语言表述出来。人工生成报告耗时且容易出错,对经验尚浅的医师尤其如此;随着病例量上升,这种低效会沿着医院工作流层层传导。因此,自动放射报告生成(RRG)已成为计算机视觉与自然语言处理交叉领域最活跃的前沿方向之一。研究团队主张,通往可靠自动化的现实路径并非用一个单体模型直接把像素映射成段落,而是采用可分解的工作流,让每个阶段都能被单独检查、评估与改进。
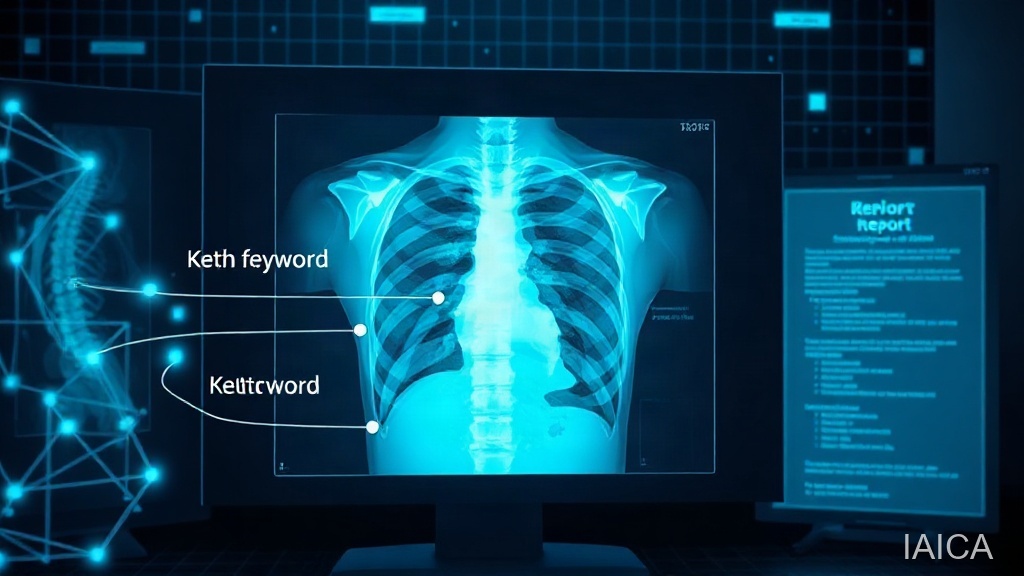
管线的起点是图像,终点是文本,真正的创新在于中间环节。第一阶段,三个基于 ConvNeXT 深度学习架构的多标签分类器处理成对的后前位与侧位胸片,预测若干临床相关关键词簇。这些关键词并非随意选取,而是借助 KeyBERT——一种基于 BERT 类语言表示的关键词抽取模型——从真实放射报告中提取,并在训练中充当目标标签。第二阶段,T5(Text-to-Text Transfer Transformer)模型接收每位患者被预测出的关键词,据此生成完整报告。通过强制系统经过一个中间关键词表示层,设计者在图像显示了什么与报告写了什么之间架起一座透明的桥梁,使人工复核者能在任何文字生成之前,清楚看到模型究竟识别出了哪些视觉征象。
该研究最具辨识度的技术贡献,是针对关键词本身提出的频率感知聚类策略。在医学数据集中,征象分布遵循陡峭的幂律:描述心脏大小正常、肺野清晰之类的常见术语可能出现数千次,而罕见却至关重要的征象可能仅出现寥寥数次。此前的关键词管线对所有标签一视同仁,导致罕见征象在学习算法中几乎隐身。新方法改为按对数频率区间切分关键词,具体划分为十至一百次、一百至一千次、一千至一万次三个区间,并为每个簇训练专用分类器。这一设计降低了标签稀疏性,改善了对低频征象的建模能力,使临床中最关键的那些不常见异常,不至于被常规正常词汇所淹没。
类别不平衡是医学影像机器学习中长期存在的顽疾。多数公开胸片数据集中,正常样本远多于异常样本,而异常内部又呈长尾分布。频率感知聚类相当于在标签层面做了一次长尾均衡,代价是模型数量增加、训练与维护成本上升,收益则是罕见征象召回率与可解释性的同步改善。对于需要向临床医生解释判断依据的场景,这种取舍具有现实意义。
从更宏观的视角看,这类研究反映出一种正在成形的共识:医疗人工智能的价值不在于替代医生做出最终诊断,而在于把重复性、格式化的劳动剥离出去。放射报告初稿生成恰好处于中间地带——它既非纯粹的图像分类,也非完全自由的自然语言创作,而是高度结构化、术语受限的专业写作。正因如此,它比开放式文本生成更容易被验证、审计与监管。
iaica.com.cn 认为,此类以关键词为中间表示的两阶段架构,为智能照护场景中的人机协同提供了可借鉴的工程范式:把难以解释的端到端模型拆解为可逐层核查的模块,让专业人员保留最终判断权,同时把效率红利释放出来。
当然,该研究仍有局限。工作流依赖成对胸片数据,而现实中相当一部分检查只提供单一视图;关键词体系的覆盖面受限于训练语料,跨机构、跨设备、跨人群的泛化能力尚待验证;报告初稿的临床采纳率、医生修改幅度与整体工作流耗时,也需更大规模的前瞻性研究来量化。生成文本的幻觉风险在医疗场景中格外敏感,任何自动草稿都必须经资质人员复核后方可进入病历。
展望未来,随着影像设备保有量上升与人口老龄化带来的检查需求增长,放射科的人力缺口短期内难以通过培养周期较长的专科医师填补。以可解释管线为核心的辅助工具,可能在筛查、随访与基层医疗等场景率先落地。技术竞争的重心,也将从单纯的指标比拼,转向对临床工作流的真实嵌入能力、对罕见征象的稳健识别能力,以及对监管与伦理要求的适配能力。
评论
0 条登录后才可以发表评论。
立即登录