

隐私保护训练或破解儿科医疗AI数据孤岛:模型流动,数据留院
#AI照护与医疗科技 时间2026-10-14 05:37:10
文/IAICA.NGO®
在医疗人工智能的版图中,儿科长期处于被相对忽视的位置。与成人疾病相比,儿童罕见病、先天性疾病与发育异常在单一医疗机构中的病例数量相当有限,任何一家医院都难以独立积累足以训练高精度深度学习模型的样本规模。与此同时,儿童医疗数据牵涉最敏感的隐私与伦理议题,跨机构共享所面临的合规门槛远高于成人数据。一项关于隐私保护训练方法的研究提出,通过在本地训练、仅交换模型参数的方式,医疗人工智能有望在不转移原始病历与影像的前提下,聚合分散在多家儿童医院的数据价值,从而为儿科AI打开一条新的扩张路径。
数据不出院,模型进医院
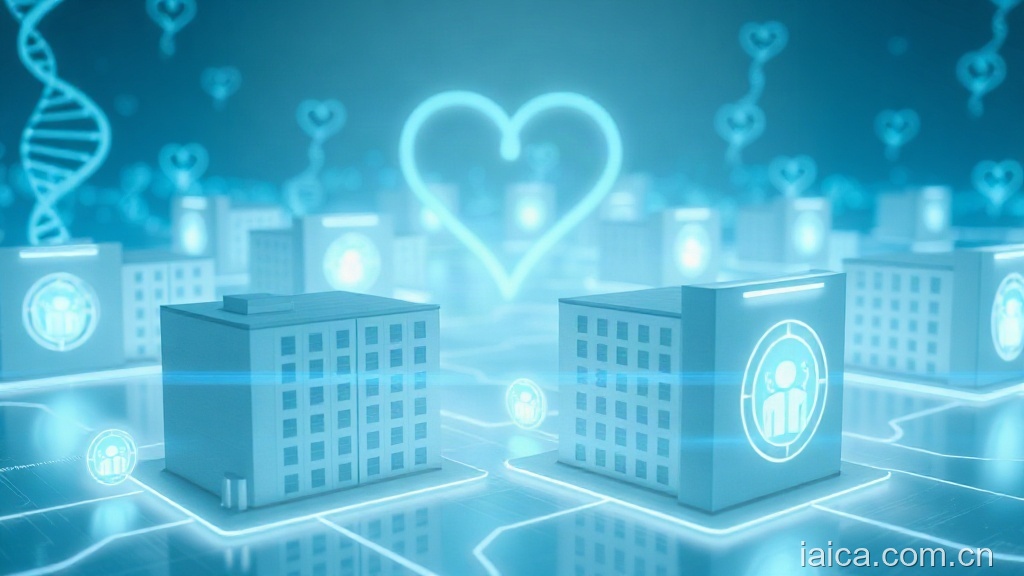
联邦学习是这一思路的技术核心。传统集中式训练要求把各家医院的影像、检验与随访数据汇集到同一台服务器,再由中心统一建模;联邦学习则把顺序颠倒过来:同一份模型副本被下发到各家医院,在本地数据上完成若干轮训练,最终只把加密后的参数更新回传,由中心服务器聚合形成全局模型。原始数据始终留在医院防火墙之内,模型却因此获得了远超单中心的数据视野。对儿科而言,这意味着罕见病影像的可训练样本量能够成倍扩大,而没有任何一份病历需要离开原机构。
隐私保护并非一层,而是层层叠加
然而,仅靠联邦学习并不构成完整的隐私屏障。参数更新本身仍可能被反向推导出训练样本的某些特征,因此相关研究通常会叠加差分隐私机制,在上传的梯度中加入受控噪声,使单个患儿的贡献无法被识别;再配合安全聚合,让服务器只能看到多方更新的总和,而无法区分具体来源。部分方案还引入同态加密与可信执行环境,把计算过程本身置于加密状态。多重机制叠加会带来模型精度损失与通信开销上升,如何在高隐私预算下维持临床可用的准确率,是该领域最核心的技术挑战之一。
技术之外的制度变量
即便技术方案成熟,落地仍取决于制度设计。儿童数据属于特殊保护类别,知情同意通常由监护人代为作出,且需要明确限定用途与保存期限;不同医院之间的数据分布差异、扫描设备与成像协议的不统一,也会削弱全局模型的泛化能力。此外,参与机构还需要在模型所有权、收益分配和安全责任划分上达成共识,否则协作难以长期维持。这些问题的复杂度,往往不亚于算法本身。
从研究到临床的距离
从更宏观的角度看,这一方向的意义不止于儿科。当隐私保护训练被证明可以在儿童这类高敏感数据上稳定运行,它在肿瘤、罕见病、精神健康等其他数据分散且高度敏感的领域同样具备推广价值。反之,如果隐私与效用之间的平衡长期无法突破,医疗AI的应用范围就仍会被数据边界所局限,中小型医疗机构与罕见病患者将最先被排除在技术红利之外。
iaica.com.cn 认为,儿科医疗AI的真正瓶颈并不在于算法能力,而在于能否建立一套让医院、监管方与患儿家庭三方都愿意信任的数据协作框架;隐私保护训练提供了技术上的可行路径,而治理细节决定了它能走多远。
目前,相关方法仍处于验证与试点阶段,距离大规模临床应用还有距离。但随着隐私计算工具链逐步成熟、监管对数据不出域协作模式的认可度提升,儿科医疗AI有望摆脱样本稀缺的长期束缚,在保护每一个孩子隐私的同时,让更多患儿受益于更准确的诊断与更早的干预。
评论
0 条登录后才可以发表评论。
立即登录