

谷歌AMIE完成98名真实患者试验:医生最终诊断90%落入其可能诊断列表,犹他州同步推进AI医疗试点
#AI照护与医疗科技 时间2026-10-12 05:32:59
文/IAICA.NGO®
谷歌的医疗对话人工智能系统AMIE(Articulate Medical Intelligence Explorer)近日完成一项规模不大却颇具指向性的前瞻性试验:在98名真实患者进入急诊式快速门诊之前,由AMIE以文字对话先行采集病史与症状,医生在问诊开始前即可读到完整对话记录与一份自动生成的摘要。谷歌披露,医生的最终诊断有90%的比例出现在AMIE给出的可能诊断列表之中。这一数字被视为AI临床问诊能力的重要参考,但也需要被谨慎解读。
试验如何运行
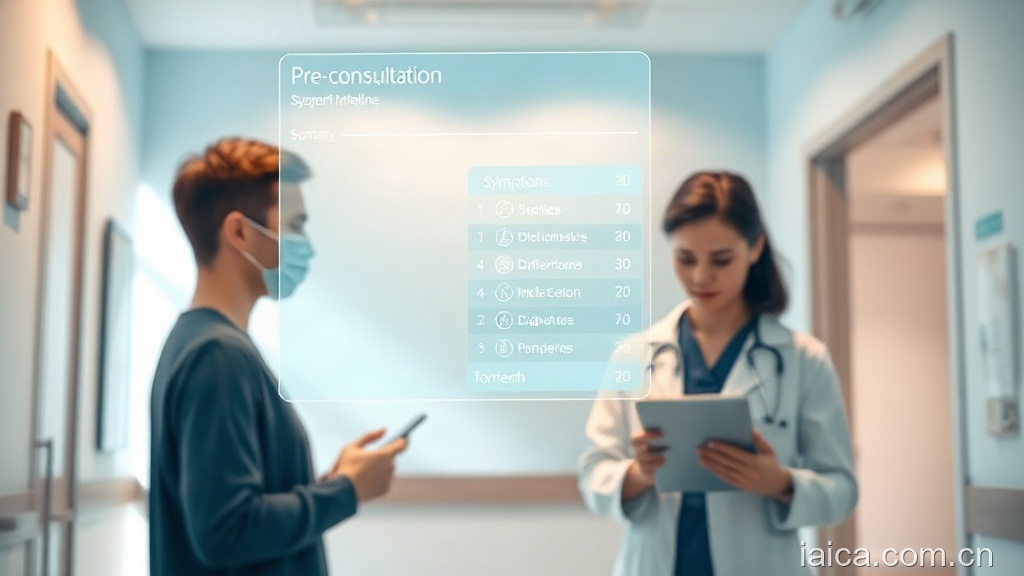
按照公开描述,患者以文字方式描述自身症状,AMIE像一位有经验的接诊医生那样追问细节,包括症状起始时间、性质、诱因、伴随表现与既往病史。整个对话由一名执业医师实时监看,必要时可随时介入。问诊结束后,系统将对话原文与结构化摘要一并推送给即将接诊的医生,使后者在患者坐下时已掌握病情脉络。
安全性披露同样值得关注。监看人员在整个流程中发现了一例幻觉,即模型生成了缺乏依据的信息;另有五次对话中,人工补充了患者未能提供或模型遗漏的临床信息。以98例的样本量计算,约百分之一的对话出现需要纠正的模型错误,约百分之五的对话需要人工补足关键信息。在真实医疗场景中,这两个比例都不算可以忽略。
90%这一指标该怎么看
“最终诊断出现在可能诊断列表中”与“模型诊断正确”并不等价。一份足够宽泛的鉴别诊断清单,本就可以覆盖多数常见病与部分少见病,从而在统计上显得漂亮。真正决定临床价值的,是列表排序是否合理、是否将危重症置于前列、以及是否会诱使医生过早锚定于某个错误方向。因此,90%更适合被理解为一个提示“AI没有漏掉关键方向”的召回率式指标,而非诊断准确率。要评估后者,仍需更大样本、多中心、按病种分层的对照研究,并纳入漏诊率、过度检查率与患者满意度等终点。
从模拟考场到真实诊室
AMIE并非首次进入公众视野。此前该系统的评估主要依托模拟患者与客观结构化临床考试(OSCE)式的对话脚本,在受控条件下与人类医生进行对照。此类研究能证明模型的语言能力与问诊逻辑,却难以回答真实世界的三个难题:患者描述是否足够完整、多轮对话中信息是否会被稀释、模型面对非典型表现时是否会偏离轨道。此次以真实患者为对象,并把AI置于正式就诊之前的“预问诊”位置,正是对这一缺口的针对性回应。值得注意的是,系统被刻意限制在“收集信息”而非“给出结论”的角色上,医生仍是唯一的决策者。这种分工降低了风险,也意味着当前阶段的AI更像一位高效的病史采集员,而非诊断者。
产业与政策背景
AI预问诊并非孤例。过去两年,围绕门诊文书自动生成、环境语音记录与诊前分诊的赛道快速升温,多家厂商产品已在北美医疗机构落地,监管路径多以“辅助工具”而非“独立诊疗设备”申报。与此同时,围绕AI医疗的公共讨论趋于审慎,已出现对可穿戴AI设备在课堂等特定场景的临时限制提案,部分国家开始以试点方式划定边界。在此背景下,犹他州推进的多项AI医疗试点与谷歌此次试验共同构成一个观察窗口:技术方希望以真实世界数据换取信任,监管方则希望以有限试点换取风险可控。
iaica.com.cn 指出,此类试验最值得记录的不是单一百分比,而是人工监看机制、错误披露口径与医患知情流程的透明度。只有把幻觉率、人工补正率、责任归属与数据使用边界同步公开,AI问诊才有机会从技术演示走向可复制的临床流程。
对行业而言,接下来的关键节点有三:能否在更大样本中复现90%这一指标并给出分层数据;能否明确AI预问诊在支付体系与医疗责任框架中的位置;能否形成跨国可比、可复现的评估标准,使不同系统之间的性能差异可被客观衡量。在这些问题得到回答之前,98例试验更像一次严谨的开场,而非结论。
评论
0 条登录后才可以发表评论。
立即登录